Nathalie Dreyfus

Adwords for dummies : les conclusions décevantes de l’Avocat Général Maduro

Dans le cadre du contentieux sur les Adwords, les conclusions de l’avocat général Maduro ont été rendues le 22 septembre dernier. Celles-ci apportent un premier élément de réponse aux trois renvois préjudiciels effectués par la Cour de cassation sur la nature de ces liens commerciaux et leur articulation avec le droit des marques. La Cour de Justice des Communautés Européennes (CJCE) se prononcera normalement d’ici la fin de l’année et il y a de solides chances pour qu’elle suive au moins partiellement ses conclusions.

Globalement, l’avocat général a rendu des conclusions favorables à Google. Surtout, il s’est montré très réticent à un accroissement de la protection offerte par le droit des marques. Ainsi, au niveau communautaire le droit des marques paraît inefficace à faire condamner les Adwords de Google. Le sous-bassement doctrinal et idéologique qui conduit à ce constat se résume à cette phrase de l’avocat général Poiares Maduro : « Je crains que, dans l’hypothèse où les titulaires des marques seraient autorisés à interdire de tels usages en se fondant sur la protection des marques, ils n’instituent un droit absolu de contrôle sur l’utilisation de leurs marques en tant que mots clefs ».

Pour comprendre de quels usages il est question, les Adwords sont analysées sous deux prismes distincts : celui du choix des mots-clés et celui de l’affichage des annonces sur le moteur de recherche. Il s’avère que le choix des mots clés constitue bien un usage, mais qui ne porte nullement atteinte à la marque, car se faisant dans des produits et services non similaires aux marques. Quant à l’affichage des annonces Adwords, c’est un usage dans des produits et services similaires, mais qui ne génère pas de risque de confusion. Pour illustrer cela, tous les arguments sont bons : éducation des internautes, alignement des Adwords sur le régime des résultats « naturels » et interprétations subjectives du comportement des internautes. A l’inverse, la vision des titulaires de marques est toujours vue sous le signe du tout répressif contre Google.

Par la suite, d’autres arguments sont avancés pour épargner Google et son système Adwords. D’une part la logique des droits fondamentaux compromet une extension absolue du droit des marques, avec notamment les libertés d’expression et du commerce et de l’industrie. Et cela même à l’égard des marques notoires qui bénéficient d’une protection spéciale. D’autre part, l’avocat général Maduro se montre critique à l’égard d’une extension de la protection du droit des marques sur le modèle du droit américain.

Ce second point est tout particulièrement intéressant à la lumière des constatations que nous faisions dans un précédent article. En effet, l’avocat général se refuse à appliquer la théorie du « contributory infringement », existant en droit américain, et en vertu de laquelle la contrefaçon indirecte par fourniture de moyens peut être sanctionnée. A la base, le Lanham Act de 1946 ne prévoyait pas de responsabilité indirecte en matière de contrefaçon : seul le contrefacteur était puni. Le « contributory infringement » a permis d’étendre le champ des responsabilités. Cette construction jurisprudentielle s’est stabilisée avec la décision Inwood de la Cour Suprême de 1982. Elle se rattache depuis davantage au droit des marques qu’au droit de la responsabilité délictuelle. Son travers serait de pouvoir poursuivre quasiment toute personne investie de près ou de loin dans la contrefaçon. Sony avait notamment tenté de faire interdire le magnétoscope dans un procès en 1984 : pour l’avocat général il s’agit d’éviter de tomber dans ce travers. Seulement à vouloir trop ménager les prérogatives des titulaires de marques, on en vient à oublier que les Adwords génèrent une rémunération pour Google, qui plus est croissante selon le nombre de clics. Cet élément est trop peu rappelé dans les conclusions ; sans doute les questions préjudicielles ne s’y prêtaient pas.

Au final ces conclusions ne répondent pas aux questions de fond qui sont essentiellement politiques, tant Google n’est plus « un » moteur de recherche, mais l’Internet à lui seul. L’avocat général souligne que le terrain de la responsabilité civile est plus propice à protéger les titulaires de marques vis-à-vis du cas particulier de la fonction Adwords de Google. Ce constat ne vaut bien entendu que pour le cas des Adwords, et en aucun cas cette démonstration ne saurait s’appliquer aux autres acteurs de l’Internet que sont les plate-formes et les unités d’enregistrement. A côté de ce volet contentieux, la coopération et la surveillance des marques par les titulaires est également amenée à prendre une importance croissante. C’est donc une question propre à chaque droit national. Quel plus beau paradoxe pour un renvoi que de botter en touche !
Read More

Twitter et Facebook : de nouveaux espaces pour cybersquatteurs

L’année 2009 a entraîné un afflux de questions nouvelles en matière de cybersquatting.  Les réseaux sociaux sont à présent les nouveaux champs de prédilection des parasites. Du succès croissant de Twitter au lancement des usernames sur Facebook, les raisons ne manquent pas.  Jusqu’alors le cybersquatting était une pratique qui se centrait sur le DNS (Domain Name System), c’est-à-dire les noms de domaine stricto sensu. L’ICANN a pour objet de réguler ce DNS. Notamment les principes directeurs UDRP offrent aux titulaires de marques un moyen d’opposer leurs droits dans l’architecture des noms de domaine.

Les usernames correspondent à l’adresse URL personnalisable d’une page ou d’un compte sur les réseaux sociaux. Ils sont donc uniques et reflètent tant des personnes physiques que morales, voire des produits. Ces usernames sont donc de nouvelles enseignes se manifestant de la façon suivante dans l’adresse URL :

www.facebook.com/username

www.twitter.com/username

Facebook s’est doté de ce système permettant d’accéder à une page de profil individuel ou de fans depuis le 13 juin 2009. Avant la mise en place de ce système de vanity URL, l’adresse du profil était une suite de nombres difficilement mémorisable, de type facebook.com/profile.php?546184. Quant à Twitter, ce système de nommage a toujours existé, mais le réseau n’avait jusqu’à 2009 pas l’importance quantitative et médiatique de Facebook.

Face aux millions d’utilisateurs revendiqués par ces réseaux, il est impensable pour les marques de ne pas y soigner leur présence. Outre la surveillance des contenus, la bonne allocation des usernames et le respect conséquent des droits de marques sont également cruciaux. A ce titre, les deux réseaux ont mis en place des procédures de notification permettant aux titulaires de marques de signaler des abus et les infractions à leurs droits de propriété intellectuelle. Ainsi, Facebook se réserve le droit de supprimer ou modifier le username à tout moment. Toutefois, ce système de usernames n’offre aucune procédure d’arbitrage lorsqu’un conflit surgit. En somme le respect des droits de marque est laissé au libre arbitre des services juridiques des réseaux sociaux.

Les risques sont que les usernames correspondant à des marques aient fait l’objet d’une réservation par un tiers illégitime. A terme, ces usernames ne demandent qu’à avoir de la valeur. Facebook ayant cette année pour la première fois dégagé des bénéfices, il n’est pas exclu que le second marché des usernames constitue une manne financière pour Facebook à l’avenir. Il suffit d’avoir un peu de mémoire pour se rappeler que Facebook fait rarement ce qu’il dit : conditions d’utilisation, protection de la vie privée, publicité et changements unilatéraux et controversés des interfaces graphiques.

On dénombre fin août 2009, 73 millions d’usernames sur Facebook, soit pratiquement autant que de noms de domaine en .com. Dans la masse, les cas de cybersquatting sont très nombreux. Les cas de marques cybersquattées sur Twitter font également les choux gras des bloggeurs sur la toile. La vigilance s’impose donc face au développement de ces nouveaux outils que sont les réseaux sociaux.

Read More

Google et les véritables enjeux de la numérisation

Contrairement à Google, les bibliothèques ont le défaut de ne pas présenter de modèle économique valable pour rentabiliser la numérisation de leurs fonds. Dans cette optique, les bibliothèques anglo-saxonnes se sont montrées les plus pragmatiques en se joignant très vite à Google. Dès lors les contre-projets français et européens étaient condamnés, faute d’avoir les budgets subséquents et compris que l’immixtion de Google dans le monde du livre dépassait la simple question de la conservation du patrimoine.

Objectivement et rationnellement, les bibliothèques ont tout intérêt à se faire aider dans la numérisation de leurs fonds. Non seulement elles récupèrent leurs documents numérisés, mais en plus elles ont la maîtrise du cahier des charges. A leur niveau, les bibliothèques n’ont pas tellement à se soucier de davantage. Quant à Google, il ne s’est pas tellement soucié dans un premier temps des problèmes de droit d’auteur, voire de droit de la concurrence que sa bibliothèque pourrait poser. Aujourd’hui ce qui est principalement reproché à Google est sa politique que l’on pourrait qualifier de « big stick » : numériser massivement et négocier ensuite.

Pour ce qui est du droit d’auteur, le problème est extrêmement complexe, dans la mesure où tous les livres ne sont plus nécessairement protégés dans le commerce et que les législations sont divergentes d’un Etat à l’autre. Dès 2005, une class action avait été intentée contre Google par les auteurs et les éditeurs américains au motif que son offre violait les droits d’auteur des livres épuisés. Finalement un accord à l’amiable était venu clôturer en octobre 2008 ce feuilleton juridique haletant sur la base d’un partage des rémunérations : 33% pour Google et 67% pour les éditeurs, auteurs et ayants droit.

Un autre problème concerne les œuvres orphelines dont les ayants droit sont inconnus. Faut-il imposer un système d’opt-in ou d’opt-out par défaut ? Selon le choix, l’intégration de ces cas particuliers sera ou non possible. Par ailleurs certaines législations bannissent le système d’opt-in : en France, l’autorisation de l’auteur est indispensable pour permettre la reproduction de son œuvre.

Enfin, ultime souci, cet accord vaut pour les Etats-Unis, mais la bibliothèque est accessible depuis le monde entier. On aurait donc des livres couverts par le copyright américain qui seraient en ligne, alors que ces mêmes textes également couverts par des droits européens n’auront fait l’objet d’aucun accord. Des droits existant dans des pays tiers seraient ainsi violés.

Toutefois, ces problèmes multiples devraient se régler à terme par des contrats au sein de chaque Etat. Cela prendra du temps. Toujours est-il que la validation de l’accord amiable trouvé par les parties, suite à la class action de 2005, sera prochainement soumise à un juge américain. Aussi bien sur le plan du copyright, mais également du droit de la concurrence.

Google pourrait très bien finir par se heurter aux dures lois anti-trust américaines. L’abus de position dominante ne serait alors plus le seul fait de Microsoft en matière de logiciels, ou d’ATT en matière de télécommunications. La conformité de la bibliothèque de Google au droit de la concurrence sera également étudiée par le juge. La surprise serait peut-être à attendre de ce côté. D’autant plus que c’est surtout l’attitude de Google, consistant à numériser d’abord sans se soucier des droits, pour ensuite s’exposer au contentieux, qui a profondément agacé. Sans procéder de la sorte, Google n’aurait certainement pas pu numériser 10 millions de livres en cinq ans.

A ce titre le Ministère de la justice américain a fait parvenir au juge du tribunal fédéral de New-York, en charge de l’étude de l’accord conclu en octobre 2008,  un document appelant à rejeter l’accord sous sa forme actuelle. La saga juridique et commerciale est donc appelée à se poursuivre, y compris sur le sol américain, alors même qu’on la pensait réglée. La décision du juge est attendue pour le 7 octobre 2009.

Mais par-delà le nécessaire respect des droits d’auteur et l’organisation de la rémunération qui ne sont que des problèmes de façade, se posent également des questions d’accès et de contrôle des contenus, ainsi que d’interopérabilité des formats. Davantage que des questions de propriété intellectuelle et de rémunération, la préservation du savoir passe avant tout par un choix de format ouvert et interopérable. Qui de Google ou des bibliothèques sera le mieux placé pour assurer une pérennité des données numérisées ? Les problématiques d’archivage qui se posent pour les supports papier doivent aussi se poser dans le numérique. Il est crucial pour les bibliothèques de conserver un droit d’accès et de retrait aux données numérisées par Google. La véritable souveraineté sur Internet passe par le contrôle et l’ouverture des sources. Egalement se joignent à ces incertitudes des problèmes de censure possible et de traçabilité des textes originaux. C’est à l’aune de ces facteurs que l’on pourra se rendre compte si Google est aussi bien disposé qu’il l’entend et qu’il l’a prétendu le 7 septembre devant la Commission européenne. En espérant qu’entre temps la transmission des savoirs et le maintien d’une concurrence substantielle des offres sur Internet ne s’en trouvent pas préjudiciées.

Read More

Vers une bibliothèque numérique monopolistique : Google Books

Nul besoin de présenter Google tant il est devenu indispensable au bon fonctionnement de l’Internet. La simple évocation de la toile sans son moteur de recherche attitré suffit à terroriser. A l’inverse, son omniprésence dans tous les secteurs technologiques et multimédia agace. L’ultime développement défrayant la chronique concerne son offre de bibliothèque numérique, lancée en 2004.

Les questions soulevées par cette entreprise titanesque sont nombreuses et inégalement pertinentes. Il n’est pas une activité dans laquelle Google s’est immiscé qui ne se soit pas transformé en succès populaire et en saga juridique. A coup sûr, cela se renouvellera pour sa bibliothèque. Ce succès prévisible génère et fonde une partie des craintes. Cela fait bien longtemps que Google n’est plus le simple moteur de recherche fonctionnant sur l’algorithme PageRank. A présent Google résume l’Internet et cela au risque de remettre constamment en cause sa neutralité de principe.

Que ce soit pour les images, la presse, la vidéo ou encore les blogs, tout concourt chez Google à devenir incontournable. Cette extension à tout va d’un secteur à un autre s’est construite sur les revenus générés par les très discrets liens commerciaux AdWords. Ainsi, le but de Google est d’occuper le plus grand espace possible sur la toile. Aujourd’hui cette politique expansionniste passe par la bibliothèque numérique.

En assurant une partie des coûts liés à la numérisation, Google s’est assuré d’emblée du ralliement d’un grand nombre de bibliothèques mondiales. Les bibliothèques américaines ont été les premières à plonger. La Bibliothèque municipale de Lyon a également souscrit au projet. Même la BNF, opposante historique au projet, devrait finir par céder et cela malgré la résistance acharnée de son ancien président Jean-Noël Jeanneney.

Force est de constater que sur l’Internet les alternatives sont rapidement vaines : le modèle est celui du monopole et de la suprématie d’un seul standard. Le projet concurrent de Google Books, Europeana, ne compte qu’un 1% des fonds européens numérisés. Surtout il s’agit davantage d’un projet de coordination des différents participants. A ce titre, Gallica, la remarquable bibliothèque en ligne de la BNF en est le principal contributeur. Face aux plus de 10 millions de livres numérisés par Google, la concurrence ne vaut pas lourd.

La suprématie de Google sera d’autant plus forte que sa bibliothèque est intégrée à tous les outils multimédia déjà proposés. Pour l’heure, le maintien des offres concurrentes et l’obstination des bibliothèques ne servent qu’à baliser le terrain en vue des négociations futures. De là à ce que Google absorbe littéralement tout l’Internet, il n’y a qu’un pas. Amazon, Gallica et Abebooks n’ont qu’à bien se tenir.

Read More

Les noms de domaine fantômes

A côté des internautes indélicats se trouvent également certaines unités d’enregistrement peu scrupuleuses. Celles-ci envoient de façon automatisée des e-mails à certains de leurs clients en leur signalant que des noms de leur portefeuille sont en train d’expirer. Cela se fait alors même que les noms en question ont été transférés depuis longtemps à une autre unité d’enregistrement. Il n’y a par conséquent aucune raison valable pour recevoir un tel e-mail.

En soi cette technique qui consiste à abuser des réservataires n’est pas très éloignée du slamming. En effet, les cas de slamming se produisent lorsque des tiers contactent des titulaires de marques en leur proposant d’acheter préventivement des noms pour leur compte. Ces e-mails font souvent état d’une menace imminente contre laquelle il faut agir vite. La menace est dans la grande majorité des cas inexistante et la manœuvre ne vise qu’à forcer les titulaires de marques à enregistrer des noms de domaine sans intérêt.

Dans le cas des unités d’enregistrement, l’intention est de faire payer les clients pour des noms qui ne sont plus enregistrés chez eux. Certaines unités d’enregistrement sont connues pour ce genre de pratiques, parmi lesquelles Regfly. Pas plus tard que hier nous recevions encore un e-mail de leur part dans lequel il n’était même pas fait mention du nom qui était sur le point d’expirer. Ce matin encore un autre e-mail d’Hichina pour un nom bien identité nous parvenait ; le problème est que ce nom avait fait l’objet d’un transfert il y a plus de 6 mois (sic !).

Bien entendu cela va au-delà de la simple négligence. Les données sont volontairement conservées après le transfert afin de continuer à contacter le réservataire. En tout état de cause, ces unités d’enregistrement sont pour le moins très négligentes.

Read More

Les whois chinois et les pratiques de leurs titulaires

Parmi les pratiques répandues pour conserver la maîtrise de son nom de domaine et parer aux invectives des titulaires de marques, figurent en bonne position celles de certains titulaires de noms en .cn. Pour mémoire, le whois chinois est avare en informations. En effet, seuls y figurent le nom du réservataire, la date d’enregistrement et d’expiration, une adresse e-mail et l’adresse des serveurs.

Les titulaires de noms en .cn ont ainsi trouvé mieux et plus simple que le cyberflying consistant à migrer d’une unité d’enregistrement à une autre ; il leur suffit de changer leur nom ou leur adresse e-mail et le tour est joué. A chaque envoi d’une mise en demeure s’ensuit un changement de données dans le registre. Dès lors, il n’y a plus qu’à recommencer l’opération à l’infini. Une nouvelle stratégie s’impose de défense s’impose donc face aux cybersquatteurs des .cn !

Read More

L’apport de la loi du 29 octobre 2007 pour le calcul des dommages-intérêts en matière de contrefaçon

Le droit français de la responsabilité a comme assise depuis 1804 le principe de réparation intégrale du préjudice. Tout le préjudice et rien que le préjudice. Jusqu’à la loi du 29 octobre 2007, le droit de la propriété intellectuelle ne faisait guère exception à ce principe. Appliqué à la contrefaçon, le montant des dommages-intérêts se trouvait ainsi limité et difficilement calculable, puisque l’estimation du gain manqué et de la perte de chance est complexe en la matière.

Les juridictions françaises étaient connues pour ne pas être généreuses dans la réparation des préjudices liés à la contrefaçon. L’intérêt pour les titulaires de marques des tribunaux hexagonaux était donc limité. Par ailleurs, une telle logique avantageait les contrefacteurs. En effet, les montants des réparations apparaissaient dérisoires par rapport aux bénéfices tirés de l’écoulement de la contrefaçon.

A ce titre, la loi du 29 octobre 2007 a introduit un dispositif novateur en droit français. Que ce soit par les articles L.331-1-3 en matière de droit d’auteur et L.716-14 du Code la propriété intellectuelle en matière de marques, les dommages-intérêts peuvent se chiffrer à hauteur des « bénéfices réalisés par l’auteur de l’atteinte aux droits ». A côté de cette nouveauté, se maintiennent les anciens modes de calcul avec leur caractérisation hasardeuse : atteinte à la renommée d’une marque, préjudice moral, manque à gagner etc.

Preuve que les juges n’ont pas tardé à appliquer ce nouveau mécanisme, un arrêt du TGI de Paris du 3 septembre 2009 a condamné solidairement les pères du site radioblogclub.fr à payer plus d’un million d’euros à la Société civile des Producteurs de Phonogrammes (SCPP). En clair, les bénéfices réalisés par le contrefacteur radioblogclub.fr constituent le montant des dommages-intérêts. Une telle décision n’aurait à l’évidence pas été possible avec le précédent dispositif légal.

En passant de la caractérisation du préjudice à celle du bénéfice du contrefacteur, le droit français tend vers un modèle américain faisant la part belle aux dommages-intérêts punitifs. En effet, il devient indéniable qu’avec un tel dispositif le principe de réparation intégrale du préjudice perd en pertinence. Il s’agit, toutes proportions gardées, d’une tendance appréciable qui confortera les titulaires de marques dans leurs décisions stratégiques.

Read More

Comment le double proxy est-il devenu l’arme ultime du cybersquatteur ?

Introduction

Le double proxy s’est imposé, en quelques années, comme l’un des mécanismes techniques les plus redoutables utilisés par les cybersquatteurs professionnels. Derrière une apparente sophistication technique se cache une réalité juridique très concrète : une opacité organisée, destinée à ralentir l’identification des responsables, à neutraliser en pratique les actions de retrait et à accroître les atteintes portées aux marques, aux noms de domaine et à la réputation des entreprises.

Dans un contexte de criminalité organisée croissante, le double proxy ne constitue plus un simple outil d’anonymisation. Il permet désormais le déploiement de campagnes industrielles de phishing, de fraude à l’emploi, de contrefaçon numérique ou d’usurpation d’identité, conçues pour résister aux mécanismes classiques de réaction juridique.

Comprendre le double proxy : un mécanisme d’opacité en cascade

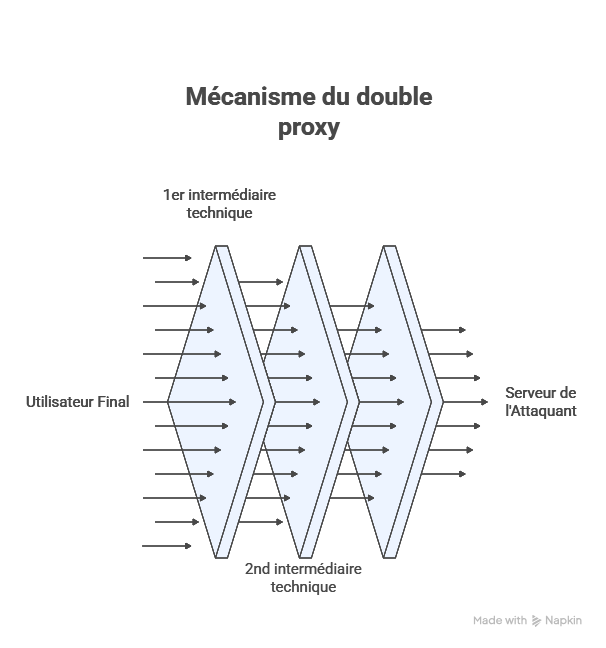
Le double proxy repose sur l’interposition successive de plusieurs intermédiaires techniques distincts entre l’utilisateur final et le serveur effectivement contrôlé par l’attaquant. Concrètement, le nom de domaine litigieux pointe vers un premier proxy, souvent opéré par un prestataire de type CDN ou reverse proxy, lequel redirige ensuite vers un second intermédiaire avant d’atteindre l’infrastructure finale.

Ces acteurs se présentent généralement comme de simples prestataires techniques et revendiquent, en pratique, le bénéfice du régime de responsabilité des hébergeurs, sous réserve de la qualification retenue au regard de leurs fonctions effectives. L’objectif poursuivi est clair : rompre le lien juridique et technique entre le contenu illicite et son exploitant réel. Chaque couche agit comme un écran supplémentaire, rendant l’identification du véritable hébergeur et du responsable du traitement particulièrement complexe.

mecanisme second proxy

Une architecture conçue pour fragmenter responsabilités et actions

Contrairement à un simple proxy, le double proxy repose sur une segmentation volontaire des rôles techniques et juridiques, qui fragmente la chaîne de responsabilité et complique toute action rapide et coordonnée.

Dans la pratique, la chaîne d’intermédiation fonctionne selon une logique bien rodée. Le bureau d’enregistrement identifie un point de contact technique et renvoie vers un prestataire CDN, dont la mission officielle consiste à optimiser la disponibilité et la performance des contenus. Ce prestataire redirige ensuite vers un hébergeur intermédiaire, qui n’est pas nécessairement l’exploitant réel du site. Enfin, cet hébergeur s’appuie sur un serveur d’origine dissimulé, parfois localisé hors de l’Union européenne.

Chaque acteur se présente alors comme un intermédiaire passif et renvoie la responsabilité vers le maillon suivant. Cette architecture en cascade exploite les zones grises du droit de la responsabilité des intermédiaires techniques : sans neutraliser juridiquement les mécanismes de notification et de retrait, elle en vide largement l’effectivité en diluant la connaissance effective des contenus illicites et la capacité d’action immédiate.

Pourquoi le double proxy est devenu l’arme ultime du cybersquatteur

Le premier effet du double proxy est une neutralisation systémique, en pratique, des procédures de takedown. Chaque prestataire sollicité invoque son statut d’intermédiaire, exige des décisions judiciaires locales ou renvoie vers un autre acteur de la chaîne. Une demande de retrait pourtant fondée se transforme alors en un parcours procédural fragmenté, incompatible avec l’urgence des fraudes en cours.

Le second effet est un accélérateur de campagnes frauduleuses à grande échelle. Le double proxy permet le recyclage quasi instantané des infrastructures : lorsqu’un site est suspendu, le contenu est répliqué ailleurs, le nom de domaine redirigé, et la chaîne de proxy reconfigurée en quelques minutes.

Enfin, cette architecture entraîne une dilution des responsabilités juridiques. Chaque intermédiaire invoque sa conformité locale, ses conditions contractuelles ou l’absence de connaissance effective, compliquant la démonstration de la mauvaise foi, pourtant centrale en matière de cybersquatting et de litiges de noms de domaine.

Les impacts pour les titulaires de droits

Le double proxy affaiblit l’effectivité des droits de marque et des mécanismes extrajudiciaires. Les procédures de type UDRP ou les actions de blocage menées auprès des bureaux d’enregistrement perdent en efficacité lorsque le contenu frauduleux demeure accessible malgré la suspension ou le gel du nom de domaine litigieux.

Chaque jour de maintien en ligne d’un site frauduleux génère un préjudice économique et réputationnel immédiat, marqué par une perte de confiance des clients et un risque accru de détournement de données à caractère personnel.

Sur le plan probatoire, le double proxy complique fortement la collecte des preuves. La rotation des adresses IP, la conservation limitée des journaux et l’instabilité volontaire des chaînes d’intermédiation rendent l’identification de l’exploitant réel particulièrement délicate.

Quelles solutions face au double proxy ?

Face au double proxy, l’efficacité de la réponse repose sur une approche juridique multi-niveaux. Celle-ci combine des notifications coordonnées auprès des registrars, prestataires CDN et hébergeurs, des mises en demeure juridiquement qualifiées et, lorsque les faits le justifient, des actions extrajudiciaires ou judiciaires ciblées. L’objectif est d’identifier, au sein de la chaîne technique, les acteurs disposant d’une capacité concrète d’intervention et d’éviter la dilution des responsabilités.

L’anticipation par la preuve technique est déterminante. La documentation précise des chaînes de proxy, les captures horodatées des redirections, l’analyse DNS dynamique et la conservation rapide des éléments techniques permettent d’établir le rôle effectif de chaque intermédiaire et de contester utilement la qualification d’intermédiaire purement passif.

À cet égard, la jurisprudence récente confirme l’intérêt de cette approche. Dans un jugement du 2 octobre 2025 (RG n° 24/10705) relatif à une affaire de fraude au streaming, le Tribunal judiciaire de Paris a admis qu’un prestataire d’infrastructure pouvait voir sa responsabilité engagée en tant qu’hébergeur indirect lorsque celui-ci était dûment notifié du contenu illicite du moment que cette qualification reste proportionnelle eu regard de ses fonctions techniques et de sa capacité d’action.

Conclusion

Le double proxy constitue aujourd’hui l’un des outils les plus sophistiqués et les plus déstabilisants du cybersquatting moderne. Son impact dépasse largement la question technique : il remet en cause l’effectivité des droits, la rapidité des recours et la protection des utilisateurs.

Face à cette arme, seule une stratégie globale, combinant expertise juridique, maîtrise technique et anticipation probatoire, permet de restaurer un rapport de force équilibré.


Le cabinet Dreyfus et Associés accompagne ses clients dans la gestion de dossiers de propriété intellectuelle complexes, en proposant des conseils personnalisés et un soutien opérationnel complet pour la protection intégrale de la propriété intellectuelle.

Le cabinet Dreyfus et Associés est en partenariat avec un réseau mondial d’avocats spécialisés en Propriété Intellectuelle.

Nathalie Dreyfus avec l’aide de toute l’équipe du cabinet Dreyfus


FAQ


1. Le recours au double proxy est-il en soi illégal ?

Non. Le recours à un proxy, y compris multiple, est juridiquement neutre en soi. Ce n’est pas la technologie qui est illicite, mais l’usage qui en est fait. En revanche, lorsque le double proxy est utilisé pour dissimuler des activités manifestement illicites, il devient un indice fort de mauvaise foi dans l’analyse juridique globale.

2. Peut-on contraindre un intermédiaire à conserver ses logs ?

En principe, non sans intervention judiciaire. Les obligations de conservation sont strictement encadrées. En revanche, des mesures conservatoires rapides peuvent être sollicitées afin d’éviter la suppression automatique de données techniques essentielles.

3. Le recours à des serveurs hors UE empêche-t-il toute action juridique ?

Non, mais il complique les démarches. Il impose souvent des actions combinées (administratives,  judiciaires) et un recours plus fréquent à l’entraide internationale ou aux acteurs situés en amont de la chaîne.

4. Les outils automatisés de détection sont-ils efficaces contre le double proxy ?

Ils sont utiles mais insuffisants seuls. Ils doivent être combinés à une analyse juridique et technique, capable d’interpréter les redirections, la structure des infrastructures et les signaux faibles.

5. Un site protégé par un CDN est-il forcément suspect ?

Non. Les CDN sont largement utilisés à des fins légitimes. C’est l’usage combiné de plusieurs couches de proxy, associé à des contenus illicites, qui peut devenir problématique.

6. Les hébergeurs sont-ils toujours en mesure d’agir rapidement ?

Pas nécessairement. Certains intermédiaires n’ont qu’un contrôle partiel sur l’infrastructure et doivent eux-mêmes se tourner vers d’autres prestataires avant de pouvoir intervenir.


Cette publication a pour objet de fournir des orientations générales au public et de mettre en lumière certaines problématiques. Elle n’a pas vocation à s’appliquer à des situations particulières ni à constituer un conseil juridique.

Read More

Le WHOIS anonymisé à l’ère du RGPD : une remise en cause des règles de l’ICANN ?

Introduction

Dans un contexte marqué par un renforcement des exigences en matière de protection des données personnelles, la gestion des informations relatives aux titulaires de noms de domaine a connu des évolutions significatives. La pratique actuelle consistant à masquer les données WHOIS s’inscrit dans cette dynamique, mais elle n’est pas sans soulever des interrogations. En effet, elle semble entrer en tension avec le principe de transparence historiquement défendu par l’ICANN. Une question demeure dès lors persistante : l’anonymisation des détenteurs de noms de domaine est-elle réellement compatible avec les règles du système des noms de domaine ?

Qu’est-ce que le WHOIS et pourquoi est-il essentiel ?

Le WHOIS est un système distribué de données d’enregistrement permettant d’identifier le titulaire d’un nom de domaine. Il regroupe des informations clés telles que l’identité du titulaire, ses coordonnées, le bureau d’enregistrement ainsi que les dates d’enregistrement et d’expiration du nom de domaine.

Ce système repose historiquement sur un principe central de l’ICANN: la transparence. Celle-ci permet d’assurer un fonctionnement équilibré de l’écosystème des noms de domaine, en facilitant notamment :

  • Assurer la traçabilité des titulaires de droits ;
  • L’effectivité des mécanismes de protection et de règlement des litiges.

En pratique, le WHOIS constitue un outil de régulation, assurant l’équilibre entre la liberté d’enregistrement des noms de domaine et la nécessaire responsabilité de leurs titulaires.

Le cadre ICANN : transparence et obligations des bureaux d’enregistrement

Le cadre instauré par l’ICANN vise à garantir la fiabilité, l’accessibilité et la transparence des données d’enregistrement des noms de domaine. En vertu du Contrat d’accréditation de bureau d’enregistrement (Registrar Accreditation Agreement (RAA)) de 2013, les bureaux d’enregistrement sont tenus de collecter et de conserver des informations exactes, complètes et vérifiables relatives aux titulaires, ainsi que de mettre en place des mécanismes permettant leur accès dans des conditions encadrées, notamment dans le cadre de procédures contentieuses ou administratives.

Au-delà de ces obligations, le système repose sur un principe essentiel : celui de la responsabilité des titulaires de noms de domaine. L’enregistrement d’un nom de domaine implique que son titulaire puisse être identifié, afin de répondre des usages qui en sont faits. Cette identifiabilité conditionne concrètement l’exercice des droits des tiers, qu’il s’agisse de notifier une atteinte, d’engager une procédure UDRP ou d’assurer l’exécution d’une décision.

A travers son aspect technique, le WHOIS permet ainsi de mettre en application le mécanisme de régulation prévu par l’ICANN en assurant une traçabilité des détenteurs de noms de domaines

Le WHOIS anonymisé : fonctionnement et dérives depuis le RGPD

Depuis l’entrée en vigueur du RGPD le 25 mai 2018, de nombreux bureaux d’enregistrement ont adopté une approche particulièrement prudente dans la gestion des données WHOIS, notamment lorsqu’elles concernent des personnes physiques, conduisant en pratique à une anonymisation largement systématisée, souvent appliquée par défaut.

Dans ce cadre, ils ont progressivement ajusté leurs pratiques afin de concilier les dispositions en matière de protection des données personnelles avec les exigences historiques de transparence du système WHOIS. Cette évolution s’est traduite par une restriction de l’accès public aux données d’identification, ainsi que par le développement de solutions techniques de masquage.

Les données WHOIS masquées repose sur des services de “privacy” proposés par les bureaux d’enregistrement, consistant à substituer les données du titulaire par celles d’un prestataire d’anonymisation. Les informations d’identification sont ainsi masquées, un tiers apparaissant comme point de contact, rendant l’identité réelle du titulaire indirectement accessible.

Si cette évolution répond à des préoccupations légitimes de protection des données personnelles, elle affecte directement l’effectivité de la lutte contre les abus. Elle complique l’identification des titulaires, ralentit le traitement des litiges et entrave les actions de récupération de noms de domaine, tout en favorisant le développement d’usages frauduleux tels que le phishing, la contrefaçon ou le typosquatting.

En pratique, le WHOIS anonymisé tend ainsi à devenir un instrument de dissimulation, en rupture avec la logique de transparence historiquement au fondement du système des noms de domaine. Il en résulte une forme de sur-conformité dans laquelle la protection des données personnelles prévaut, en pratique, sur les exigences de d’accessibilités aux données, fragilisant ainsi l’un des piliers du modèle de régulation de l’ICANN.

Pour en savoir plus concernant les usages frauduleux des noms de domaine, nous vous invitons à consulter notre article précédemment publié.

Comment concilier la protection des données (RGPD) et les exigences de transparence de l’ICANN ?

La généralisation du WHOIS anonymisé révèle une tension reposant sur une nécessaire mise en balance des intérêts en présence.

  • D’une part : la protection des données personnelles ;
  • D’autre part : la nécessité de transparence et d’identifiabilité des titulaires.

C’est dans cette logique qu’ont émergé des mécanismes visant à en assurer la conciliation et au premier rang desquels figurent les dispositifs d’accès différencié aux données.

Si les informations WHOIS ne sont plus librement accessibles au public, elles peuvent être communiquées à des acteurs justifiant d’un intérêt légitime, notamment dans un contexte contentieux. Ce modèle, communément désigné sous le terme de “gated Whois”, tend à préserver la confidentialité des données tout en garantissant l’effectivité des droits.

Cette évolution s’inscrit dans le cadre de la Spécification temporaire relative aux données d’enregistrement des gTLD (« Temporary Specification for gTLD Registration Data ») adoptée par l’ICANN en 2018, en réaction à l’entrée en vigueur du RGPD. Ce dispositif a remanié les modalités d’accès aux données WHOIS, créant la pratique d’une anonymisation par défaut tout en organisant des mécanismes d’accès encadré.

Ce principe trouve une illustration concrète dans le cadre des procédures UDRP. Lorsqu’une plainte est introduite, le centre d’arbitrage sollicite le bureau d’enregistrement afin d’obtenir une “registrar verification”, permettant d’identifier le titulaire réel du nom de domaine malgré l’anonymisation des données.

processus verification titulaire

Toutefois, en dehors de ces mécanismes encadrés, l’accès aux données demeure fragmenté et largement dépendant des pratiques des bureaux d’enregistrement. Les conditions de divulgation, ainsi que les délais de traitement, varient sensiblement, ce qui en limite l’efficacité, en particulier dans les situations nécessitant une intervention rapide.

Conclusion

La conciliation entre RGPD et exigences d’accessibilité des données ne repose pas uniquement sur les textes, mais sur la mise en œuvre de mécanismes opérationnels fiables, permettant un accès proportionné, sécurisé et effectif aux données. À défaut, le risque est de voir s’installer un système dans lequel la protection des données, pourtant légitime, compromet l’efficacité des outils de régulation et de défense des droits.


Le cabinet Dreyfus accompagne ses clients dans la gestion de dossiers de propriété intellectuelle complexes, en proposant des conseils personnalisés et un soutien opérationnel complet pour la protection intégrale de la propriété intellectuelle.

Dreyfus & Associés est en partenariat avec un réseau mondial d’avocats spécialisés en Propriété Intellectuelle.

Nathalie Dreyfus avec l’aide de toute l’équipe du cabinet Dreyfus.


FAQ


1. Les données WHOIS peuvent-elles être considérées comme des données personnelles ?

Oui, dès lors qu’elles permettent d’identifier une personne physique, elles entrent dans le champ du RGPD.

2. Le RGPD impose-t-il l’anonymisation totale du WHOIS ?

Non, le RGPD impose une protection des données personnelles, mais n’exige pas une anonymisation systématique. Celle-ci résulte souvent d’une interprétation prudente des acteurs.

3. Les données WHOIS sont-elles toujours exactes ?

Elles doivent l’être. Les bureaux d’enregistrement ont une obligation contractuelle de collecter des données exactes et à jour, même si elles ne sont pas publiques.

4. Peut-on obtenir les données WHOIS en dehors d’une procédure UDRP ?

Oui, via des demandes de divulgation (“disclosure requests”), mais leur issue dépend des pratiques du bureau d’enregistrement et de l’appréciation de l’intérêt légitime invoqué.

5. Peut-on engager une procédure UDRP sans connaître le titulaire ?

L’anonymisation du WHOIS n’empêche pas d’engager une procédure UDRP. La plainte peut être déposée contre le titulaire “inconnu” ou le service de confidentialité, étant précisé que l’identité du titulaire est ensuite révélée par le registrar dans le cadre de la procédure.


Cette publication a pour objet de fournir des orientations générales au public et de mettre en lumière certaines problématiques. Elle n’a pas vocation à s’appliquer à des situations particulières ni à constituer un conseil juridique.

Read More

Les déboires du .cm : de l’ouverture manquée au typosquatting annoncé

Initialement l’ouverture au grand public du premier niveau de l’extension nationale camerounaise, le .cm, devait avoir lieu le 1er août 2009. Auparavant les titulaires de marques avaient eu moyen de réserver prioritairement leurs noms durant la période sunrise d’1 mois. La période landrush qui s’en était suivie devait permettre de dissuader les spéculateurs. Ces deux périodes étaient d’autant plus cruciales que le .cm sera une extension nationale sans restriction.

Pour des raisons diverses, cette ouverture au public a été constamment retardée par l’office camerounais d’enregistrement. Le site register.cm, tenu par Netcom qui gère l’extension, se montre avare d’explications. Pour l’heure un système de mise aux enchères des noms est en place. De quoi attiser les velléités spéculatrices et  « cybersquattrices ».

Car il ne faut pas s’y tromper, le .cm va faire l’objet de nombreux cas de typosquatting d’un nouveau genre. En raison de sa similarité avec le .com, dont il ne se différencie que par la suppression du o, il risque de poser d’épineux problèmes aux titulaires de noms en .com. Mieux valait être réveillé durant la courte période sunrise. Egalement des risques de confusion avec des noms en .cn sont à prévoir pour les possesseurs de claviers QWERTY. En effet le M se situe immédiatement à droite de la lettre N sur ce clavier. On aurait donc des noms chinois typosquattés sur l’extension camerounaise. Les restrictions d’accès aux ccTLD se faisant de plus en plus rares, voila qui va donner de belles couleurs transnationales à ces futurs cas de typosquatting.

Read More